
Ve naší facebookové skupině o umělé inteligenci se během jednoho týdne sešly hned tři dotazy, které na první pohled nemají nic společného. Učitel chtěl z dvaceti stránek přijímacího testu vyrobit věrnou kopii a dostal rozbitý výstup. Jiný člen skupiny měl 450 fotografií textu, dohromady 800 MB ve dvou ZIP archivech, a nepodařilo se mu je do ChatGPT ani do Claude vůbec nahrát. Třetí potřeboval zanalyzovat geologické zprávy, z nichž každá má kolem 1 500 stran a přes gigabajt, a napsal, že „standardně narazí na limity“.
Za všemi třemi dotazy stojí totéž: uživatel naložil modelu víc, než jeho pracovní paměť a rozhraní unese. Pracovní paměť má jméno a říká se jí kontextové okno. Pokusím se tedy nejprve vysvětlit, co to je, proč se model chová hůř, když je okno plné, kde leží hranice u modelů (dostupných v září 2026) a jak úlohy přeskládat, aby se do ní vešly.
Co je kontextové okno
Jazykový model jako takový, odpovídá-li, nedisponuje pamětí v lidském smyslu. Mezi dvěma dotazy si nic nepamatuje; každou odpověď skládá výhradně z toho, co má v daném okamžiku před sebou. Má kontext: systémovou instrukci provozovatele, celou dosavadní konverzaci, přiložené soubory, výsledky nástrojů, případně vlastní „přemýšlení“ a nakonec i právě generovanou odpověď. To všechno se počítá v tokenech, kdy jeden token je zhruba jedno anglické slovo. Český text vychází na dva až tři tokeny na slovo, tedy hůř než angličtina, a stejný obsah proto v češtině zabere víc místa.
Tady se sluší předejít námitce, kterou slýchám často: „Ale můj ChatGPT přece paměť má, pamatuje si věci z jiných konverzací.“ Pamatuje, ale to není model. Funkce paměti v ChatGPT i v Claude je součást aplikace, která běží kolem modelu – nástavby, rozhraní. Aplikace si z konverzací ukládá poznámky do vlastní databáze a při každém novém dotazu vybrané poznámky vloží na začátek kontextu, vedle systémové instrukce. Model je tedy „čte“ znovu při každé odpovědi, stejně jako přílohu nebo předchozí zprávy, a stejně jako ony zabírají místo v okně. Totéž platí pro odkazování na dřívější chaty, kde aplikace v historii vyhledá relevantní úryvky a přiloží je. Z pohledu modelu je to všechno jeden vstup, který vznikl před chvílí. Dojem trvalé paměti vytváří obal, samotný model zůstává bez paměti a jeho tabule má pořád stejnou velikost. Dalo by se říci, že čím více si o vás rozhraní zapsalo poznámek, tím méně pak zbývá kontextu na samotnou konkrétní úlohu a odpověď.
Kontextové okno je horní mez toho, kolik tokenů model pojme najednou. Představte si to jako klasickou školní tabuli: dokud je na ní místo, píšete. Když ji celou popíšete, další písmena už nenamalujete a musíte odmazávat. To přirovnání sedí i v detailu, který se často přehlíží. Token, který se do okna nevešel, pro model neexistuje. Mechanismus pozornosti počítá vztahy pouze mezi tokeny přítomnými ve vstupu; co tam není, nemá žádnou reprezentaci, na kterou by se model mohl odvolat. Přetečení okna tedy není mírné zhoršení kvality. Rozhraní API vrátí chybu, chatovací aplikace odmítne přílohu nebo bez upozornění odřízne začátek konverzace. Nebo častěji odpoví, ale bez znalosti kompletního vstupního textu.
Jak funguje pozornost a proč není zadarmo
Abych mohl vysvětlit, proč se model při plném okně chová hůř, potřebuji alespoň zhruba popsat, co uvnitř dělá. Transformer, architektura, na níž stojí všechny dnešní velké modely, pracuje s mechanismem pozornosti (attention) [1]. Zjednodušeně: při zpracování každého tokenu si model „položí otázku“, které ostatní tokeny v kontextu jsou pro něj relevantní, a každému z nich přiřadí váhu. Každý token se tedy dívá na každý jiný token.
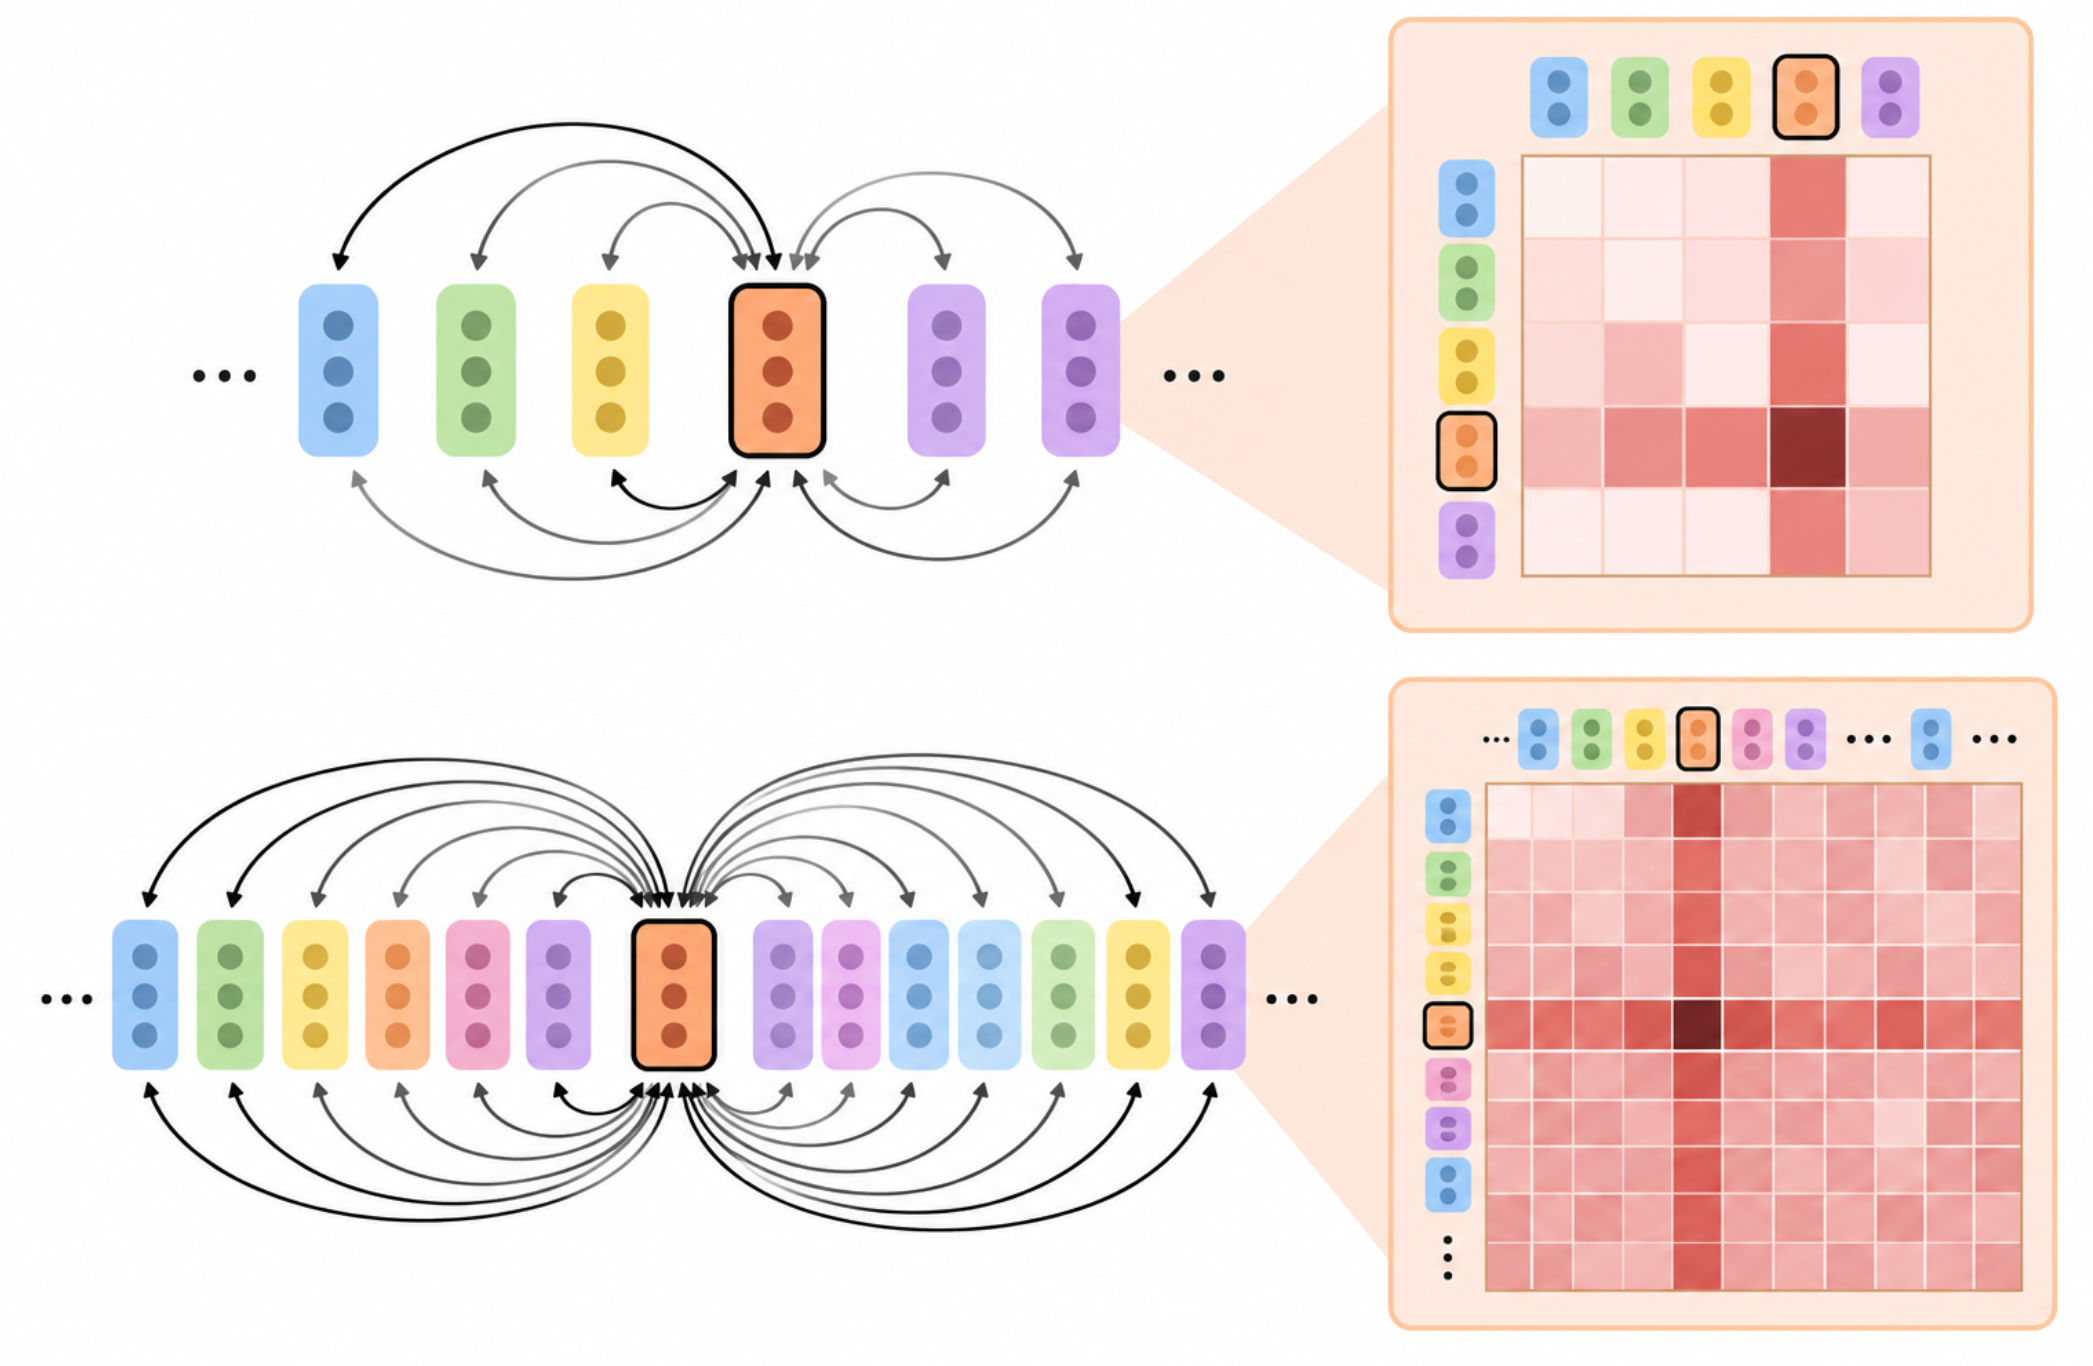
Z toho plynou dvě věci. Výpočetní náročnost roste s druhou mocninou délky kontextu; dvojnásobný kontext znamená čtyřnásobek párových vztahů. Proto byly milionové kontexty tak dlouho drahé nebo nedostupné a proto u některých poskytovatelů začíná nad určitou hranicí, typicky 200–270 tisíc tokenů, vyšší cenová sazba, nebo a to je přirozené nižší přesnost v odpovědích.
Pozornost je konečný zdroj, který se rozděluje. Čím víc tokenů se o ni hlásí, tím menší díl připadne na ty, které skutečně nesou odpověď. Sémanticky podobné, ale irelevantní pasáže, takzvané distraktory, se chovají jako šum, který relevantní signál přehlušuje.
K tomu přistupuje pozicové kódování. Model musí nějak vědět, na kterém místě v sekvenci token stojí. Kódování pozic se učí při tréninku na určitých délkách, a na vzdálenostech, které model v tréninku neviděl dost často, jeho spolehlivost klesá. Výrobci to řeší různými technikami rozšiřování, žádná z nich ale jev neodstraňuje úplně.
Ztracen uprostřed
Nejznámější empirický popis chování modelu na dlouhém kontextu podali Liu a kolegové v práci Lost in the Middle [2]. Testovali modely na úlohách, kde odpověď ležela v jednom z mnoha dokumentů vložených do kontextu, a systematicky měnili pozici toho správného. Výsledkem byla křivka ve tvaru písmene U: modely si vedly nejlépe, když relevantní informace stála na začátku nebo na konci kontextu, a výrazně hůř, když stála uprostřed. U některých modelů byl výkon s klíčovou informací uprostřed horší, než když dokument nedostaly vůbec. Pro lepší pochopení opět příklad. Představte si studenta, který má omezený čas na zpracování výpisků z knihy. Nemá kapacitu na přečtení celé. Co udělá? Pravděpodobně si přečte úvod a konce (nebo záložku na poslední straně se shrnutím). Podobně postupuje i model.
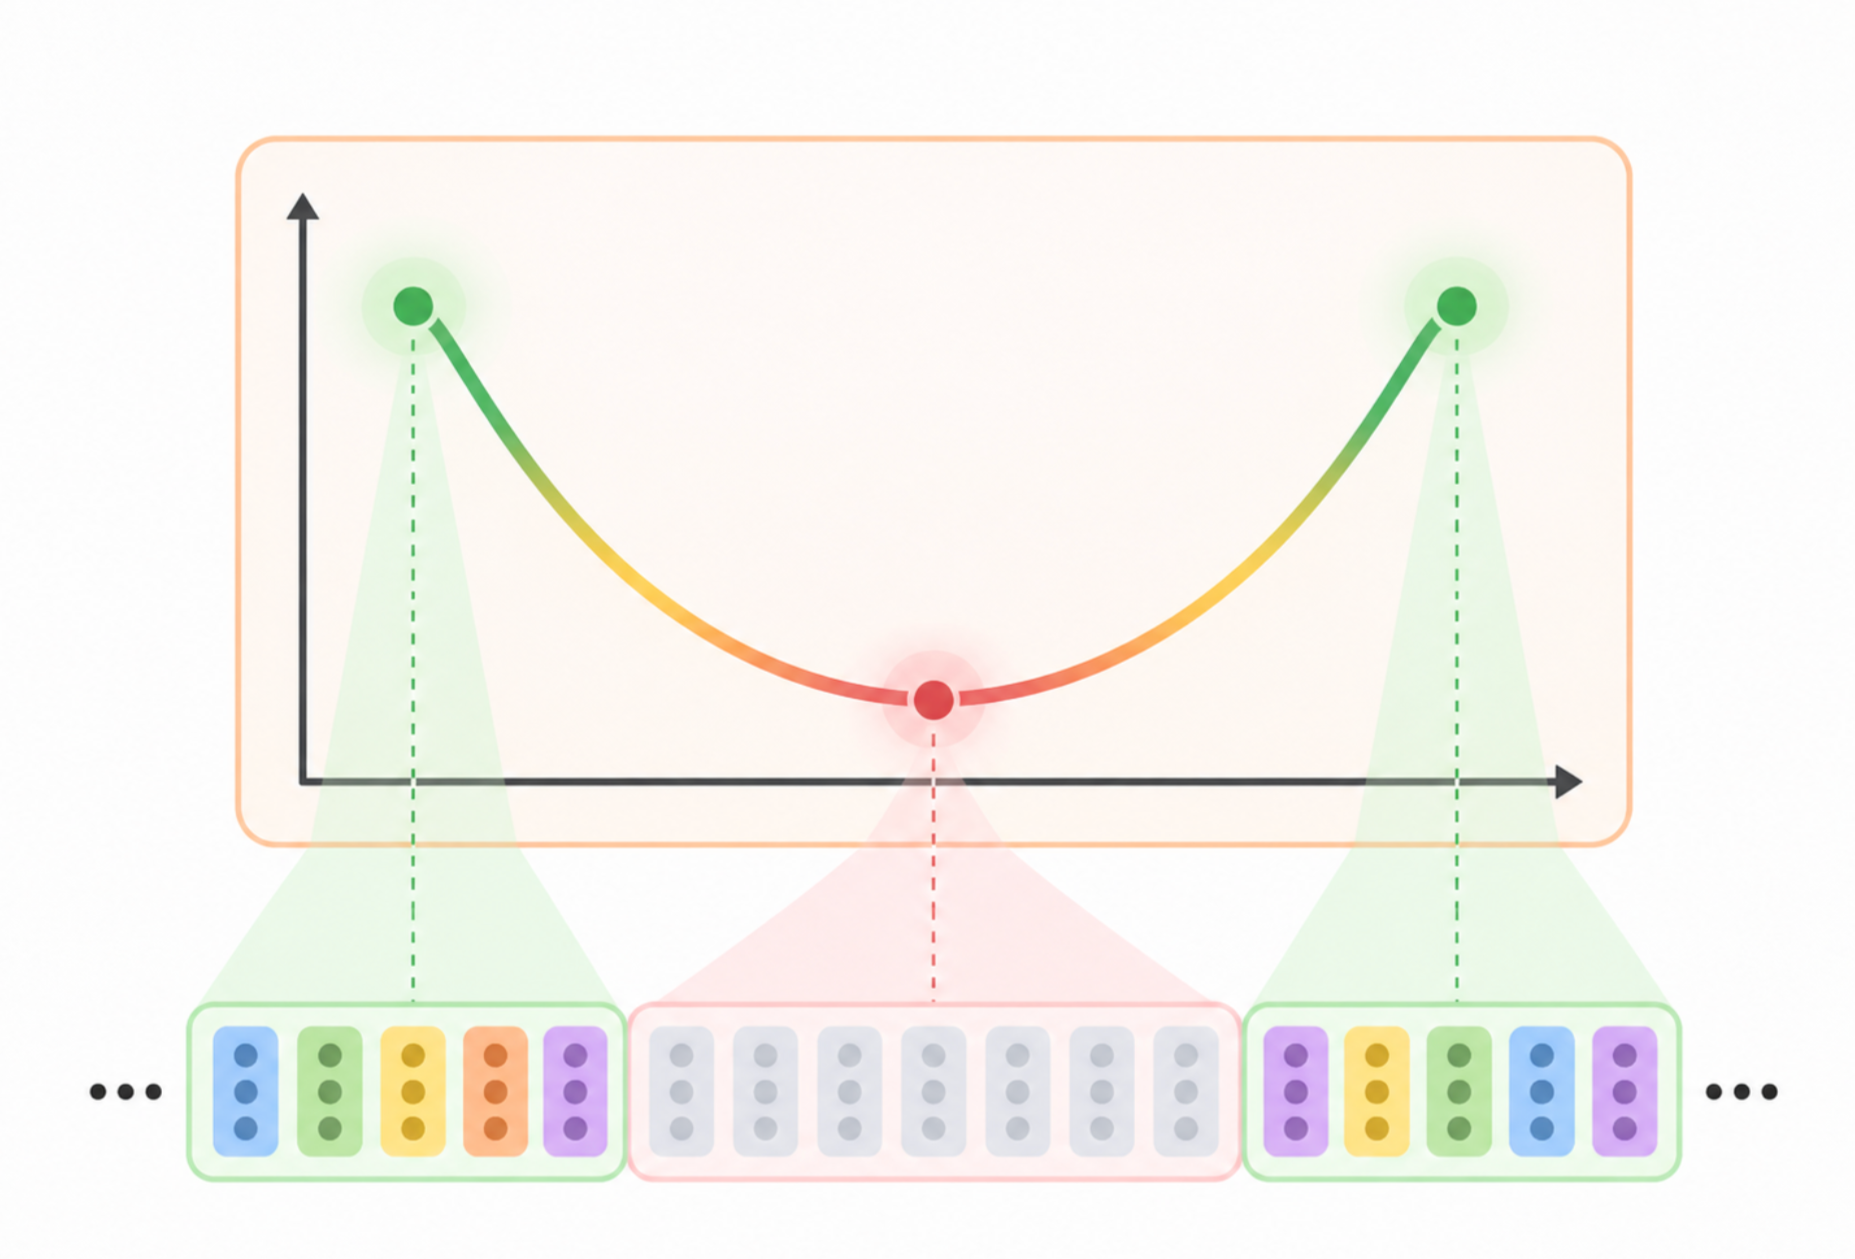
Pro učitele s testem z toho plyne konkrétní věc. Když vloží dvacet stran a chce jejich věrnou kopii, úlohy na straně deset dostanou strukturálně méně pozornosti než úlohy na stranách jedna a dvacet. Výstup rozbitý zrovna uprostřed je vlastnost mechanismu, se kterou žádná formulace instrukce nic neudělá.
Následující výzkum obraz zpřesnil. Benchmark RULER od NVIDIA [3] ukázal, že efektivní kontext, tedy délka, na které model ještě drží kvalitu z krátkých vstupů, je typicky jen 50–70 % nominální hodnoty. Práce NoLiMa [4] doplnila, že jehla v kupce sena je snadná, dokud lze hledaný fakt najít podle doslovné shody slov; jakmile je potřeba shoda sémantická a otázka s odpovědí nesdílejí žádné klíčové slovo, výkon většiny modelů na dlouhých vstupech prudce padá. A zpráva Chroma Research o „context rot“ [5] doložila, že zhoršování je pozvolné a začíná dávno před dosažením limitu. Modely na stejné úloze podávají horší výkon prostě proto, že vstup je delší, i když přibylý text nic relevantního neobsahuje. Dlouhá konverzace, ve které jste už pětkrát opravovali výstup, je proto sama o sobě horším pracovním prostředím než nová konverzace s čistým zadáním.
Co dalšího hraje roli
Vstupní okno je nejviditelnější omezení, ale zdaleka ne jediné. V praxi selhává práce s velkými daty i z důvodů, které s délkou vstupu souvisejí jen nepřímo, a uživatel je snadno přehlédne.
Začnu výstupem. Model může sice na vstupu přijmout milion tokenů, ale na výstupu vygeneruje v jedné odpovědi typicky 64 až 128 tisíc [11]. Generování je navíc autoregresivní: každý další token stojí na těch předchozích. U dlouhého výstupu, jako je dvacet stran testu v LaTeXu, se chyby kumulují a model má ke konci sklon zkracovat, zobecňovat nebo shrnovat místo doslovné reprodukce. Řekl bych, že učitelův test selhal spíš tady než na vstupu.
Druhým faktorem je aplikační vrstva, o které uživatel obvykle neví. Když nahrajete velký soubor do ChatGPT nebo Claude, aplikace ho zdaleka ne vždy vloží celý do kontextu. U větších příloh sáhne po vlastním vyhledávání nad dokumentem a model dostane jen vybrané úryvky. Uživatel si myslí, že model četl celé PDF; ve skutečnosti viděl deset fragmentů, které vybral jiný algoritmus. K tomu se přidává ztráta struktury při převodu. PDF s tabulkami, sloupci a zlomky se rozpadne na lineární text, a mapy nebo grafy zmizí úplně, pokud se nezpracují zvlášť jako obrázky. Navíc v závislosti na tom, zda máte placený nebo bezplatný účet, a také na typu modelu bývá kontextové okno v rozhraní chatu obvykle menší, než jaké model sám umožňuje při přímém volání přes API.
Třetím je poměr instrukcí a dat. Zadání o pěti větách se vedle dvaceti stran materiálu stane statisticky zanedbatelným. Instrukce se v kontextu rozředí a model sklouzne k tomu, čeho je v datech nejvíc, místo k tomu, co jste chtěli. S tím souvisí kontaminace vlastními chybami. Jakmile model v dlouhé konverzaci jednou vyprodukuje chybný výstup, ten výstup je odteď součástí kontextu a model se na něj při dalších pokusech odvolává. Opravování v jednom vlákně proto dopadá hůř než nový start.
Čtvrtým je jazyk. Čeština se tokenizuje na víc kusů než angličtina, takže stejný obsah zabere víc okna, a v tréninkových datech pro dlouhé vstupy je jí výrazně méně. Degradace na dlouhém kontextu je u neanglických jazyků měřitelně strmější.
A pátým je rozpočet na přemýšlení. U modelů s režimem uvažování se úvaha počítá do stejného okna jako vstup a výstup. Plný vstup tak zároveň ukrajuje z prostoru, ve kterém má model úlohu vyřešit.
Hranice v září 2026
Doposud jsme rozebírali principy, které platí. Teď k aktuálnímu stavu, který zestárne nejrychleji a za půl roku platit nemusí. Během první poloviny roku 2026 se všichni tři hlavní poskytovatelé dostali na kontextové okno jednoho milionu tokenů. Google ho měl u Gemini od února 2024, Anthropic otevřel milionový kontext u Claude Opus 4.6 v únoru 2026 a v březnu jej zpřístupnil obecně, OpenAI ho po mezikroku zpět na 256K vrátila u GPT-5.4 [7]. V létě 2026 mají milionové okno za standardní cenu i Claude Sonnet 5 a Opus 4.8 a od července Claude Opus 5; podle srovnání Morph nabízí milion a více tokenů třináct modelů včetně otevřených [11]. Samotné číslo 1M tedy přestalo být rozlišujícím znakem.
Rozlišujícím znakem se stala spolehlivost. Nejpřísnějším veřejně používaným měřítkem je dnes benchmark MRCR v2 ve variantě s osmi jehlami: model má v dlouhém textu najít a doslovně reprodukovat osm zadaných informací. Tady se čísla rozcházejí zásadně. Claude Opus 4.6 dosahuje na 256 tisících tokenů kolem 92–93 % a na jednom milionu 76 %, zatímco jeho předchůdce Sonnet 4.5 měl na stejném testu 18,5 % [6], [7]. GPT-5.6 Sol podle nezávislého měření drží 91,5 % v pásmu 256K–512K a 73,8 % v pásmu 512K–1M [8]. Gemini 3 Pro se v době měření pohyboval na jednom milionu kolem 25 %, byť na 128 tisících se novější Gemini 3.1 Pro s Claude Sonnet 4.6 prakticky vyrovnal [7].
Modely, které v pásmu kolem půl milionu tokenů deklarují přes 90% přesnost při vyhledávání konkrétních faktů, tedy existují; jde o špičkové modely Anthropicu a OpenAI z jara a léta 2026. Do půl milionu tokenů se přesto nedá bezstarostně naházet cokoli, a důvody stojí v poznámkách pod čarou. Údaje o vlastních modelech jsou z větší části vlastní měření výrobců. Benchmark se během roku ztížil, takže starší a novější čísla nejsou přímo srovnatelná [12].
Co z toho plyne do budoucna
Ať už za rok budou čísla jakákoli, několik principů zůstane. Kontext je rozpočet, ne odkladiště; každý token, který nenese informaci potřebnou k odpovědi, snižuje kvalitu odpovědi. Pozice v kontextu není neutrální; začátek a konec jsou privilegované, prostředek je nejzranitelnější. Typ úlohy rozhoduje víc než délka; vyhledat fakt je řádově snazší než agregovat, porovnat nebo reprodukovat strukturu. Výsledky benchmarků jsou horní odhad; efektivní kontext je vždy menší než nominální. A výstup má vlastní, o řád menší limit, který se na dlouhých reprodukcích projeví dřív než limit vstupu.
Z těchto principů se odvíjejí doporučení, která platí napříč nástroji.
- Rozdělit úlohu na části tak, aby každá jednotlivá výzva pracovala s kontextem hluboko pod limitem, a to včetně výstupu.
- Nejdůležitější instrukci a klíčová data umístit na začátek, a je-li zadání dlouhé, stručnou rekapitulaci požadavku zopakovat na konci.
- Pro každou samostatnou dílčí úlohu začínat novou konverzaci, místo pokračování v té, která už nese balast předchozích pokusů.
- A nakonec tam, kde jde o přesnost, sáhnout po vyšším modelu s aktivním uvažováním.
Literatura
[1] VASWANI, Ashish, SHAZEER, Noam, PARMAR, Niki et al. Attention Is All You Need. In: Advances in Neural Information Processing Systems 30 (NIPS 2017). Long Beach: Curran Associates, 2017, s. 5998–6008.
[2] LIU, Nelson F., LIN, Kevin, HEWITT, John et al. Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics. 2024, roč. 12, s. 157–173. DOI 10.1162/tacl_a_00638.
[3] HSIEH, Cheng-Ping, SUN, Simeng, KRIMAN, Samuel et al. RULER: What’s the Real Context Size of Your Long-Context Language Models? arXiv preprint arXiv:2404.06654 [online]. 2024 [cit. 2026-09-13]. Dostupné z: https://arxiv.org/abs/2404.06654
[4] MODARRESSI, Ali, DEILAMSALEHY, Hanieh, DERNONCOURT, Franck et al. NoLiMa: Long-Context Evaluation Beyond Literal Matching. arXiv preprint arXiv:2502.05167 [online]. 2025 [cit. 2026-09-13]. Dostupné z: https://arxiv.org/abs/2502.05167
[5] HONG, Kelly, TROYNIKOV, Anton a HUBER, Jeff. Context Rot: How Increasing Input Tokens Impacts LLM Performance [online]. Chroma Research, 2025 [cit. 2026-09-13]. Dostupné z: https://research.trychroma.com/context-rot
[6] ANTHROPIC. Claude Opus 4.6 [online]. 2026 [cit. 2026-09-13]. Dostupné z: https://www.anthropic.com/news/claude-opus-4-6
[7] YAGE.AI. Long Context Benchmarks: All Three Hit 1M – Now What? [online]. 15. 3. 2026 [cit. 2026-09-13]. Dostupné z: https://yage.ai/share/long-context-benchmark-en-20260315.html
[8] TECH-INSIDER.ORG. Claude Fable 5 vs Opus 5 vs GPT-5.6 Sol [online]. 2026 [cit. 2026-09-13]. Dostupné z: https://tech-insider.org/claude-fable-5-vs-opus-5-vs-gpt-5-6-sol-2026/
[9] SCOUT: Active Information Foraging for Long-Text Understanding with Decoupled Epistemic States. arXiv preprint arXiv:2605.04496 [online]. 2026 [cit. 2026-09-13]. Dostupné z: https://arxiv.org/abs/2605.04496
[10] AIMULTIPLE. VELC-Bench: Verification on Long Context Benchmark [online]. 4. 8. 2026 [cit. 2026-09-13]. Dostupné z: https://aimultiple.com/ai-context-window
[11] MORPH. LLM Context Window Comparison (2026): 20 Models From 200K to 10M Tokens [online]. 9. 6. 2026 [cit. 2026-09-13]. Dostupné z: https://www.morphllm.com/llm-context-window-comparison
[12] R&D WORLD. Claude Opus 4.6 targets research workflows with 1M-token context window, improved scientific reasoning [online]. 5. 2. 2026 [cit. 2026-09-13]. Dostupné z: https://www.rdworldonline.com/claude-opus-4-6-targets-research-workflows-with-1m-token-context-window-improved-scientific-reasoning/


